

Tag
vLLM
3 articles tagged with “vLLM”
A/B-testinga-starA2AACRadaptive-thinkingagent-observabilityagent-patternsagent-protocolsagent-securityagent-skillsagentsAGENTS.mdaggregationaiai-gatewayAI-SearchaksalertingAlertmanageralgorithmsAnthropicAnthropic-APIAPEapi-designapi-gatewayAPI-providersapi-versioningapimAPMapp-routerapp-serviceappsecarchitectureArizearm-templatesASP.NET-Coreaspnet-coreaspnetcoreassertion-functionsassertsasyncauditauthenticationauthorizationAutoGenautomationazureAzure-APIMazure-content-safetyazure-front-doorazure-functionsAzure-OpenAIazure-policyazure-storagebatch-APIbddbeam searchBedrockbenchmarksbest-practicesbfsbi-encoderbias-detectionbicepbinary-searchbranchingbstBundlercache-componentscachingcap-theoremcapability-taggingCapitalizecascadingcase-based-reasoningchain-of-thoughtchartschatbotcheckpointingchunkingCIci-cdci-optimizationcicdclass-decoratorClaudeClaude-CodeCLAUDE.mdclean-architecturecloudcloud-securitycloudeventscode-reviewCodexcoding-agentscompactioncomparisoncompilerOptionscompliancecomposeconcurrencyconcurrent-renderingconditional-typesconsistencyconsistent-hashingconstrained-generationconstraintsconsumer-drivencontainer-registrycontainerscontent-moderationcontent-safetycontextcontext-compressioncontext-engineeringcontext-windowcontract-testingconversational-agentsCopilotcosmos-dbcost-allocationcost-controlcost-optimizationcost-per-taskcost-performanceCoTcoveragecqrscross-sessioncsharpCursorcvecypress.d.tsdapperdashboardsdastdata-fetchingdatabasesdataloaderdatasetsddddecision-frameworkdeclaration-filesdecoratorsDeepEvalDefinitelyTypeddependency-injectiondependency-scanningdeployment-slotsdeploymentsdeprecationdesign-patternsdevopsdfsdijkstradiscriminated-unionsdistributed-tracingdistributivedockerDocker-HubdocumentationDORAdotnetdotnet-9drift-detectionDSPydurable-executiondynamic-discoverydynamic-programminge2e-testingedge AIef-coreef-core-9embeddingsengineeringenvironmentsepisodic-memoryerror-budgetevalsevaluationevent-drivenevent-gridevent-hubseventingexamplesexperience-replayexperimentalDecoratorsfactualityfail-fastfaithfulnessfeature-flagsfederationfew-shotfiberfine-tuningFinOpsflaky-testsflex-consumptionfrontendfunction-callinggarakGeminiGemmagen-ai-semantic-conventionsgenericsGHCRgitGitFlowGitHubgithub-actionsgoal-decompositiongolden-signalsGoogle-DeepMindGPTgpt-4oGPT-6GPUgrammargraphgraphqlGroqgroundingGroupChatgrpcguardrailshallucinationhallucination-detectionharmful-contentharness-engineeringhclhealth-checksheapHelmhookshotchocolateHPAhttphttp2http3hybridcacheiacICLidempotencyidentityimage-scanningin-context-learningincident-responseindexesinferinferenceinfrastructureinput-validationintegrationintegration-testinginteroperabilityintrosortinvariantisolationIstiojailbreakjestjoinsjotaiJSONJSON-modejsonbjwtk8skey-remappingkey-vaultkiotaknapsackknowledge-baseKQLkubernetesKV cacheLangChainLangfuseLangGraphLangSmithlanguagelatencyleast-agencylegacy-codeLinkerdlinqLlamallama.cppLLMLLM-as-judgeLLM-monitoringLLM-securityload-balancinglogginglong-running-agentslong-term-memorylost-in-the-middlelower-boundmanaged-identitymapped-typesmaterialized-viewsMCPmemoizationmemorymemory-consolidationmergemessage-queuemessagingmeta-promptingmetadatametricsmicroservicesmicrosoftminimal-apisMistralmockingmocksModel-Context-Protocolmodel-routingmodel-selectionmodel-servingmoderationmodule-augmentationmodule-resolutionmodulesmongodbmonitoringmonorepomswMTEBmTLSmulti-agentmulti-stage-buildsmulti-tenantmultimodalmvccnarrowingnetwork-securitynextjs-16Node16normalizationnosqloauthoauth2observabilityoffline-evalsoidcOmiton-callon-deviceonline-evalsopaopen-sourceopen-weightOpenAIOpenAI-APIopenapiOpenTelemetryOPROorchestrationOTELOutlinesoutput-formatoutput-validationOWASPP99paaspackage-exportspactpactflowpage-objectsPagerDutyparsingPartialpartitioningpathspattern-matchingperformancepersonal-AIpgvectorPhiPhoenixPickPIIPII-filteringpineconepipelineplanningplaywrightpluginspolicy-as-codepollypostgresqlpricingproductionproduction-monitoringprogressive-disclosureproject-referencesprompt-cachingprompt-designprompt-engineeringprompt-injectionprompt optimisationpromptfooprotobufpulumipythonQdrantqualityquality-gatesquality-scorequantizationqueuesRAGRAG-evaluationRAGASrate-limitingreactreact-19react-compilerreact-internalsreact-queryreact-server-componentsrealtimereasoningreasoning-effortRecordrecursionrecursive-typesred-blackred-green-refactorred teamingredisreflectionregression-testingrelease-managementreplanningresource-limitsResponses-APIrestreusable-workflowsrlsrolling-updatesruntime-safetysaga-patternsandboxingsastsbomscaleschemaschema-designschema-validationSDKsdlcsearchsecrets-managementsecuritysecurity-testingself-consistencyself-hostingSemantic-Kernelsemantic-similarityserializableserver-actionsserverlessservice-busservice-meshshardingshortest-pathsidecar-proxysignalrSKILL.mdSLISLMSLOslopsquattingsnapshot-testingsoftware-designsortingspec-driven-developmentspeculative-decodingspiessqlstabilitystate-graphstate-managementstreamingstreamsstrict-modestridestring-typesstructured-loggingstructured-outputstubssummarisationsupertestsupply-chainsystem-designtail-calltanstack-querytask-framingTC39tddtemplate-literalstemplatesterraformtest-architecturetest-doublestest-pyramidtestcontainerstestingtesting-patternstesting-strategythreat-modelingtoken-buckettoken-budgettoken-economicstoken-limittoken-maskingtoken-trackingtokenstokens-per-secondtool-callingtool-registrytool-usetopological-sortToTtoxicitytracingtrajectorytransactionstree-of-thoughttreestrietrunk-basedtsconfigTTFTtype-guardstype-narrowingtype-predicatestype-safe-routestype-systemtype-transformstypestypescriptunit-testingusage-metricsuser-feedbackutility-typesvalidationvalkeyvaluesvaultvector-dbvector-searchvector-storevendor-neutralverificationversion-controlversioningVertex-AIvisual-regressionvitestvLLMvoice-agentsvulnerabilitiesweaviateweb-apiweb-securityWebLLMwebsocketswindow-functionsWindsurfwiremockworkflowsworking-memoryworkload-identityworkspacesxunityarpzero-shotzero-trustzodzustand
LLM Model Landscape
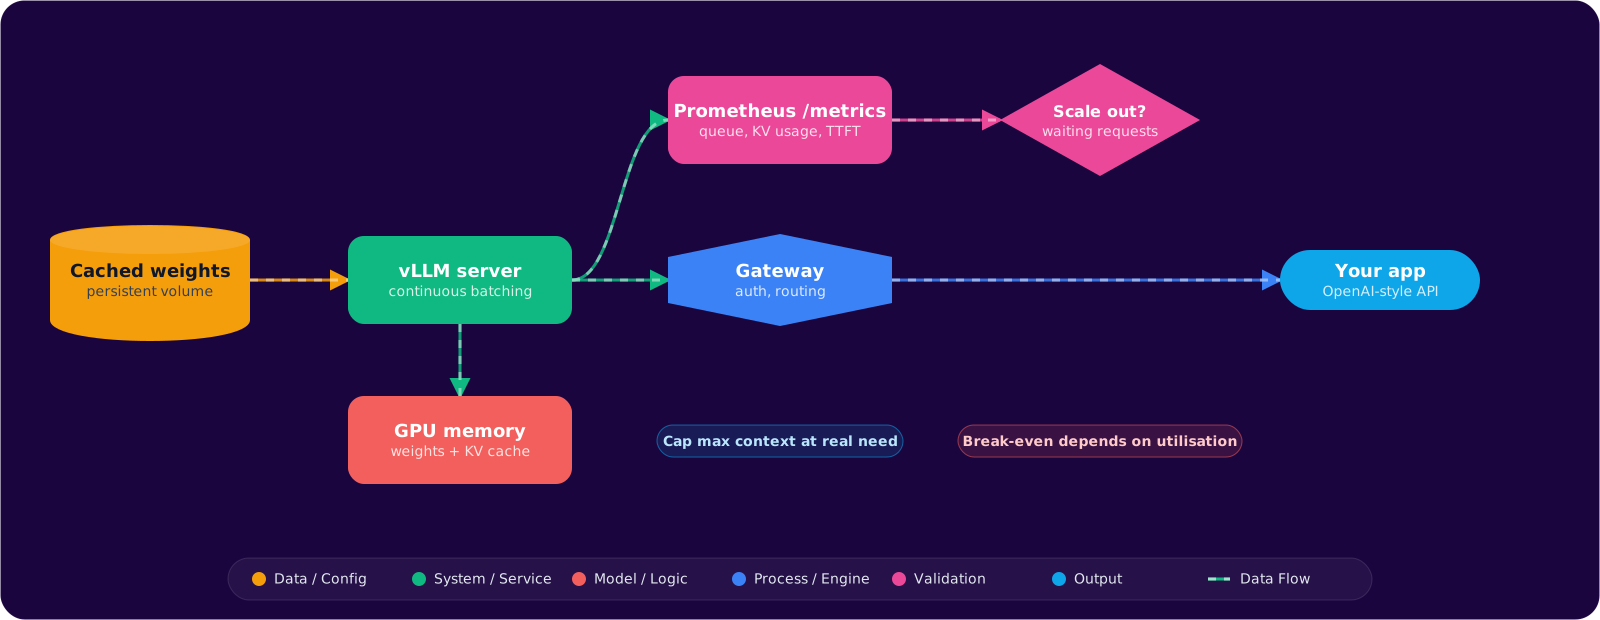
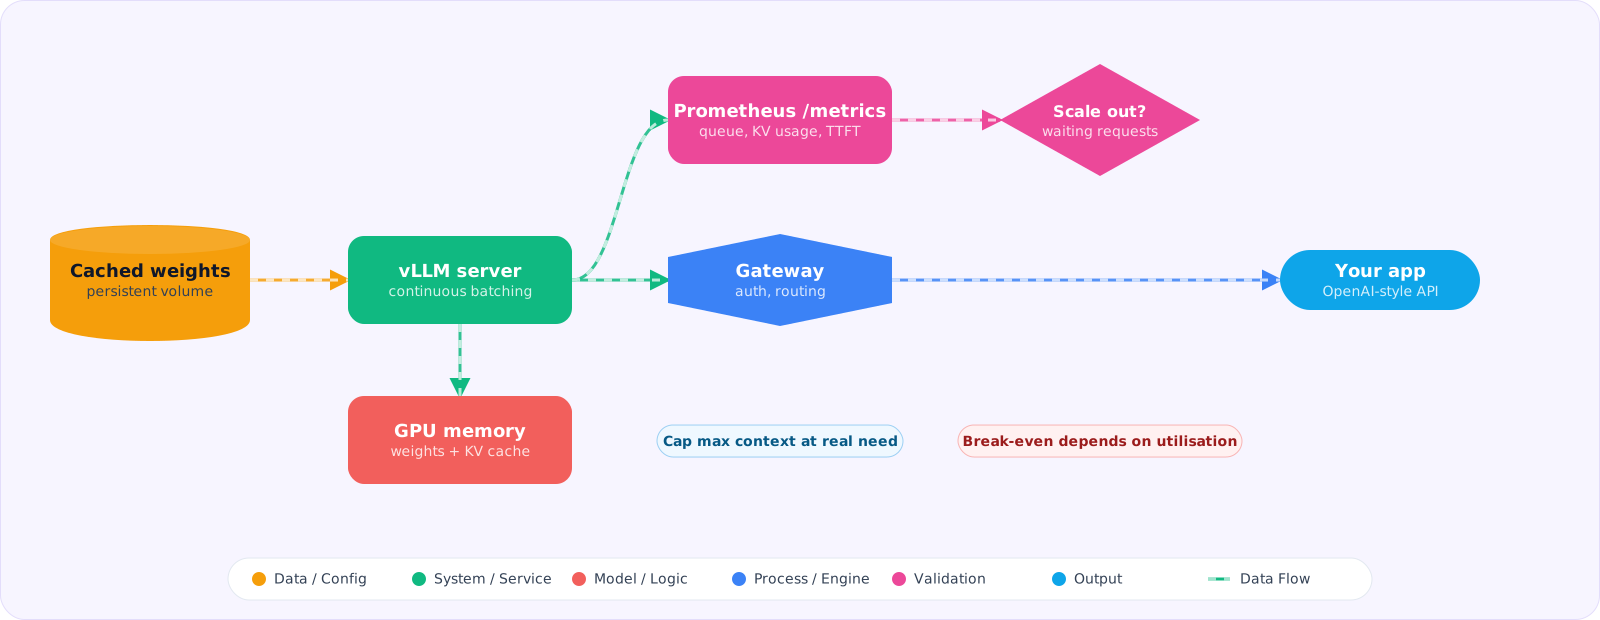
Self-Hosting LLMs: Running a Model as a Service
AdvancedPRO
Break-even maths, GPU sizing from weights and KV cache, choosing between vLLM, SGLang and llama.cpp, and what to scale and alert on once open-weight models carry production traffic.
9 min
Read →LLM Model Landscape
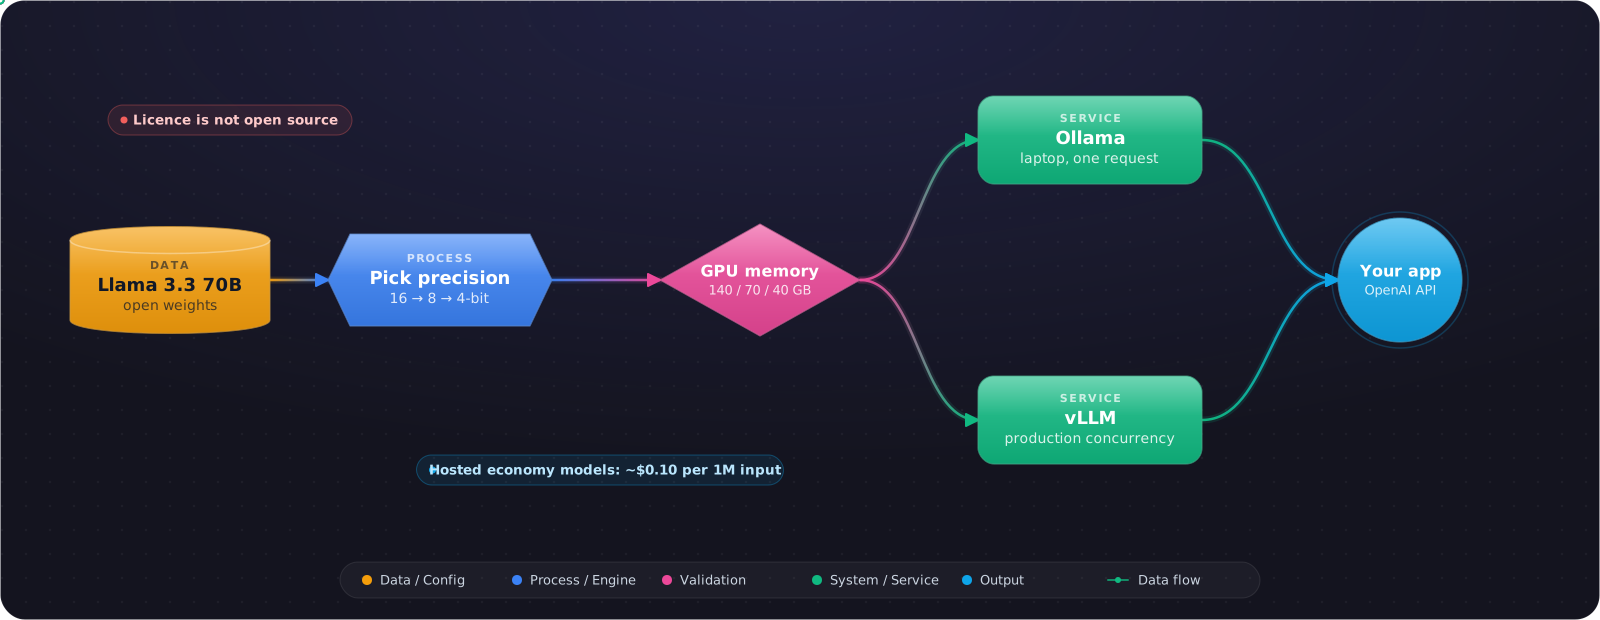
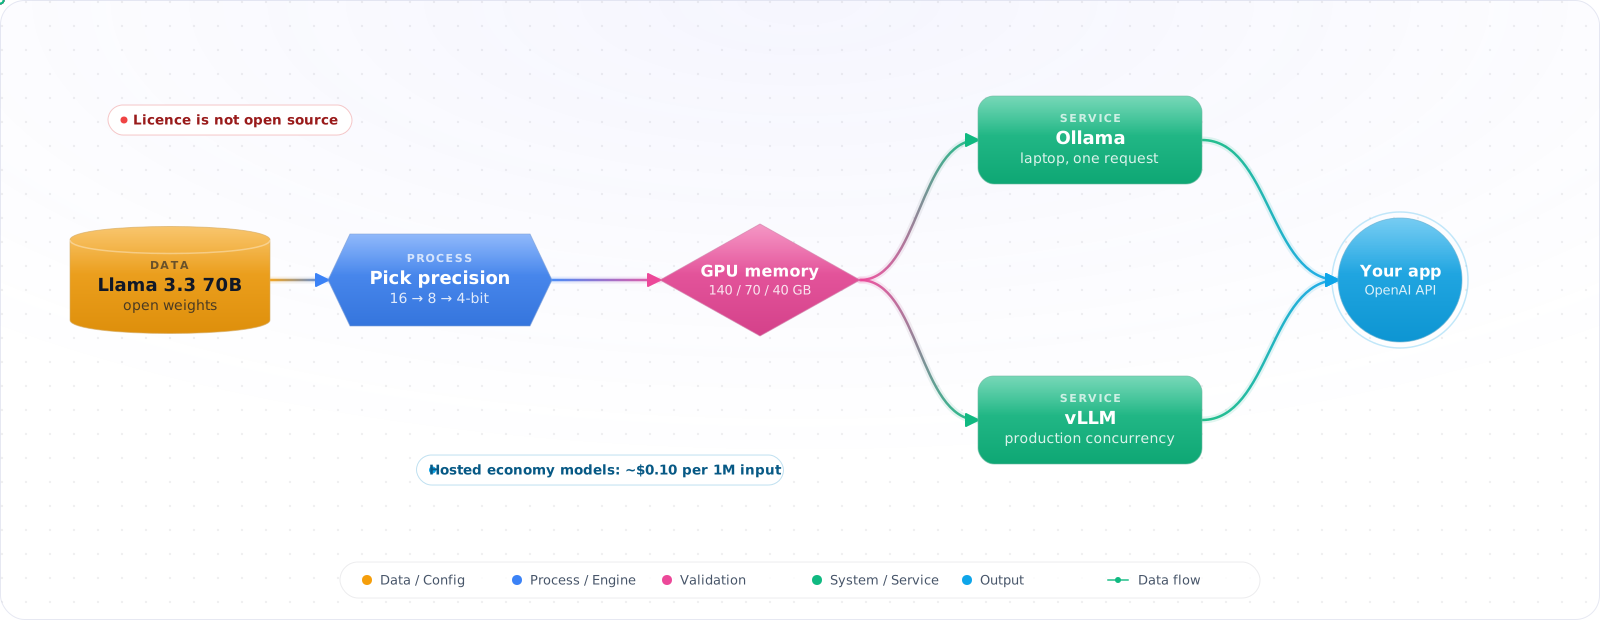
Llama: Open-Weight Models for Production
Intermediate
The Llama lineup and licence, serving with Ollama and vLLM, GPU memory sizing, and an honest look at when a hosted API is still the better choice.
Updated 11 min
Read →AI Engineering
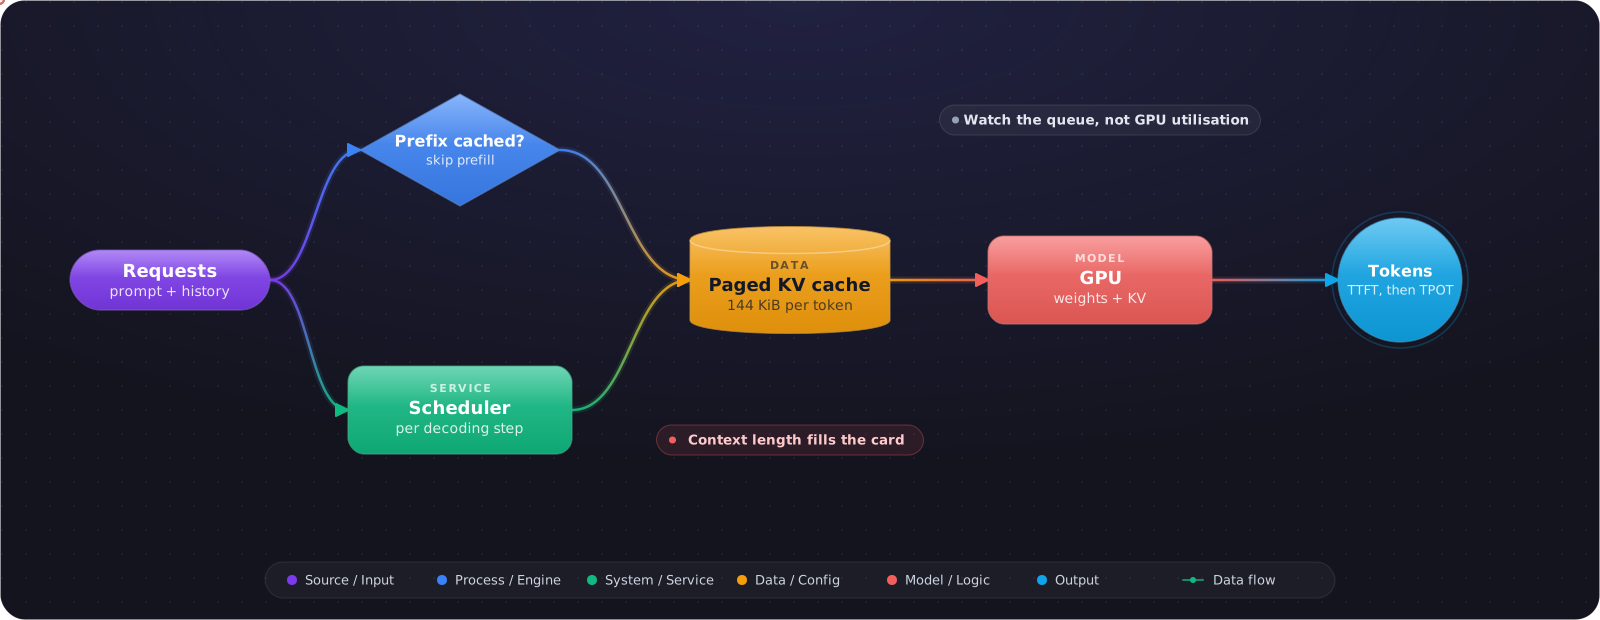
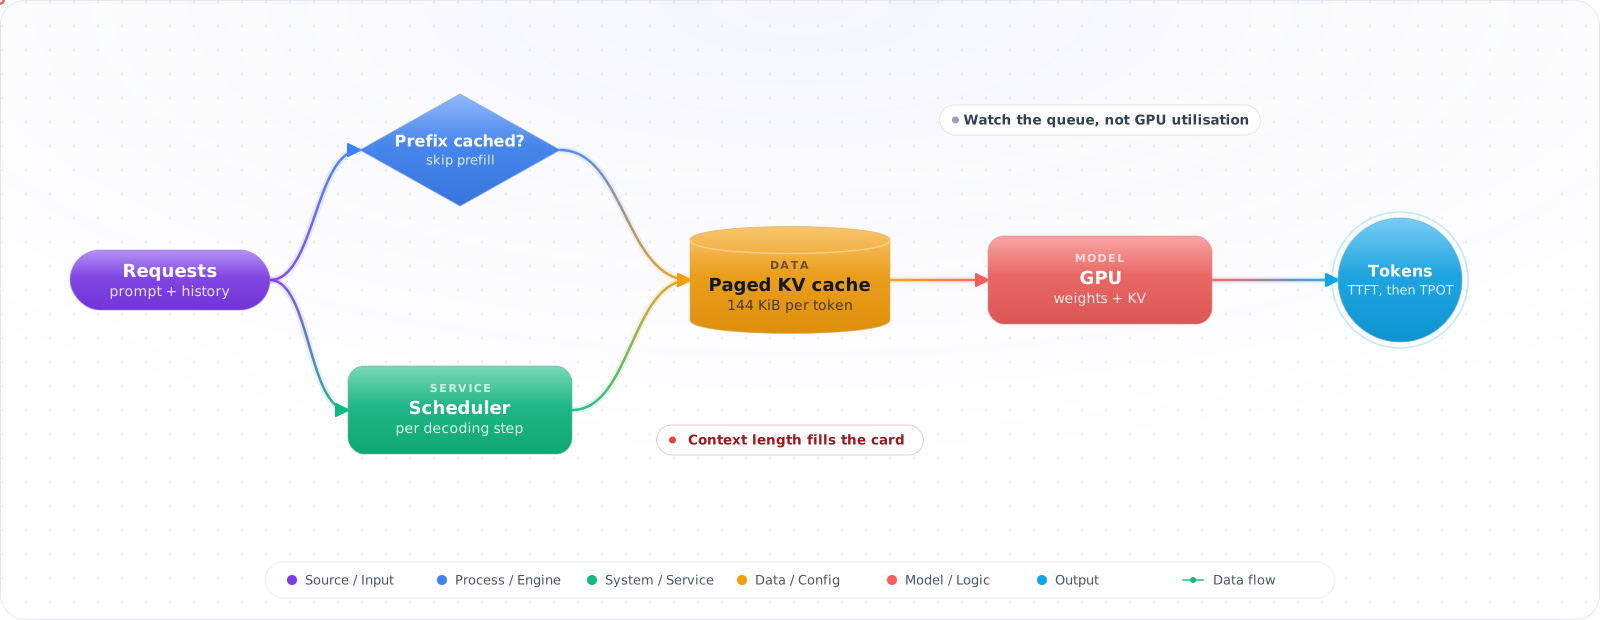
Model Serving With vLLM: The KV Cache Decides Your Capacity
Advanced
KV cache arithmetic, PagedAttention, continuous batching, prefix caching, FP8 and speculative decoding, the vLLM flags that matter, and the five metrics that show which limit you hit.
8 min
Read →